Java 类型转换主要分为基本类型之间的数值转换和引用类型之间的转换两种。
一、不同类型的转换
| 转换 | 示例 | 主要动作 |
|---|---|---|
| 基本类型宽化 | int → long | 将数值转换为目标基本类型的表示 |
| 基本类型窄化 | int → byte | 可能截断高位,改变数值 |
| 装箱 | int → Integer | 得到表示该数值的包装对象引用 |
| 拆箱 | Integer → int | 从包装对象中取得基本类型值 |
| 向上转型 | String → Object | 编译期可证明安全,通常不需要额外的运行时类型检查 |
| 向下转型 | Object → String | 通常需要在运行时检查实际对象的类型 |
显式写出强转运算符,不代表一定发生窄化,也不代表一定生成 checkcast。例如,long c = (long) a 中的 int → long 是拓宽转换,去掉 (long) 仍然可以编译。
引用类型转换不会把对象改造成另一种对象。转换成功后,引用仍然指向同一个对象;对象的实际类型没有改变。涉及泛型时,还存在未经检查的转换与类型擦除等情况,本文不展开。
二、基本类型转换:从数值到字节码
先看一组包含数值转换、装箱和拆箱的示例:
| |
使用IDEA的bytecodeViewer,可以看到如下关键指令:
| |
其中L0、L1通过istore、astore将int a、Integer b放入局部变量表。L2、L3、L4分别完成原方法中第3-5行的转换。L6为此方法的局部变量表。
2.1 int → long:符号扩展
对应 long c = (long) a 的指令是:
| |
iload 从局部变量表中加载 a,将其压入操作数栈;i2l 弹出一个 int 值,将其转换为 long 后压栈;lstore 再将结果存入从槽 3 开始的两个局部变量槽。
根据 JVMS §6.5 i2l,这一步通过符号扩展将 32 位整数转换为 64 位整数。所有 int 值都可以被 long 精确表示,因此转换不会损失数值信息。
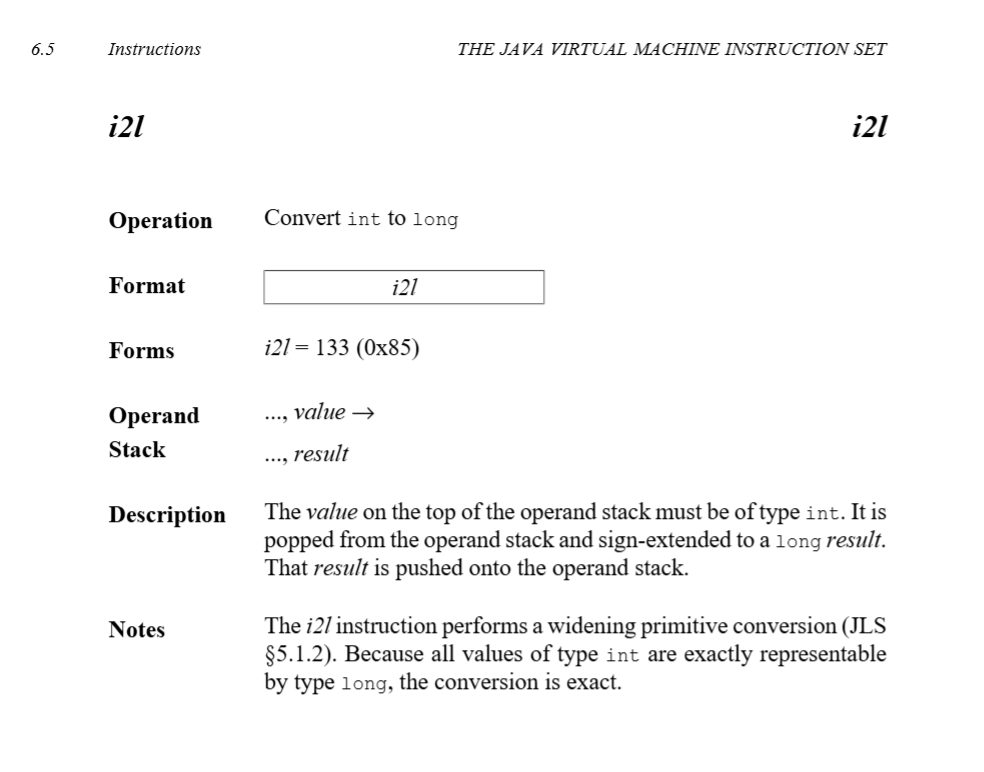
图 1: i2l 规范
在 templateTable_x86_64.cpp 的 TemplateTable::convert() 中,对应分支如下:
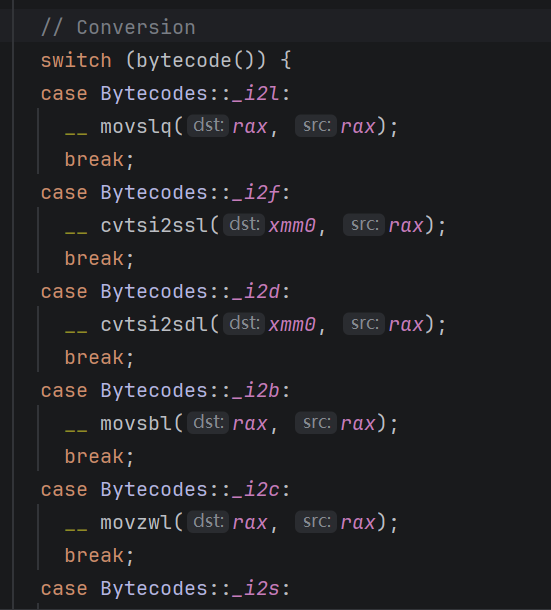
图 2:转换分支截图。i2l 使用 movslq,i2f 使用 cvtsi2ssl。
movslq 是 HotSpot 汇编器的代码生成方法。主要用于生成机器指令写入jvm的缓冲区。
| |
对于 movslq(rax, rax),生成的指令按 Intel 语法表示为:
| |
它读取 eax 中的 32 位有符号整数,符号扩展后写入 rax,即从 4 字节扩展为 8 字节。REX.W 用于选择相应的操作数宽度,符号扩展的语义则由 MOVSXD 指令决定。
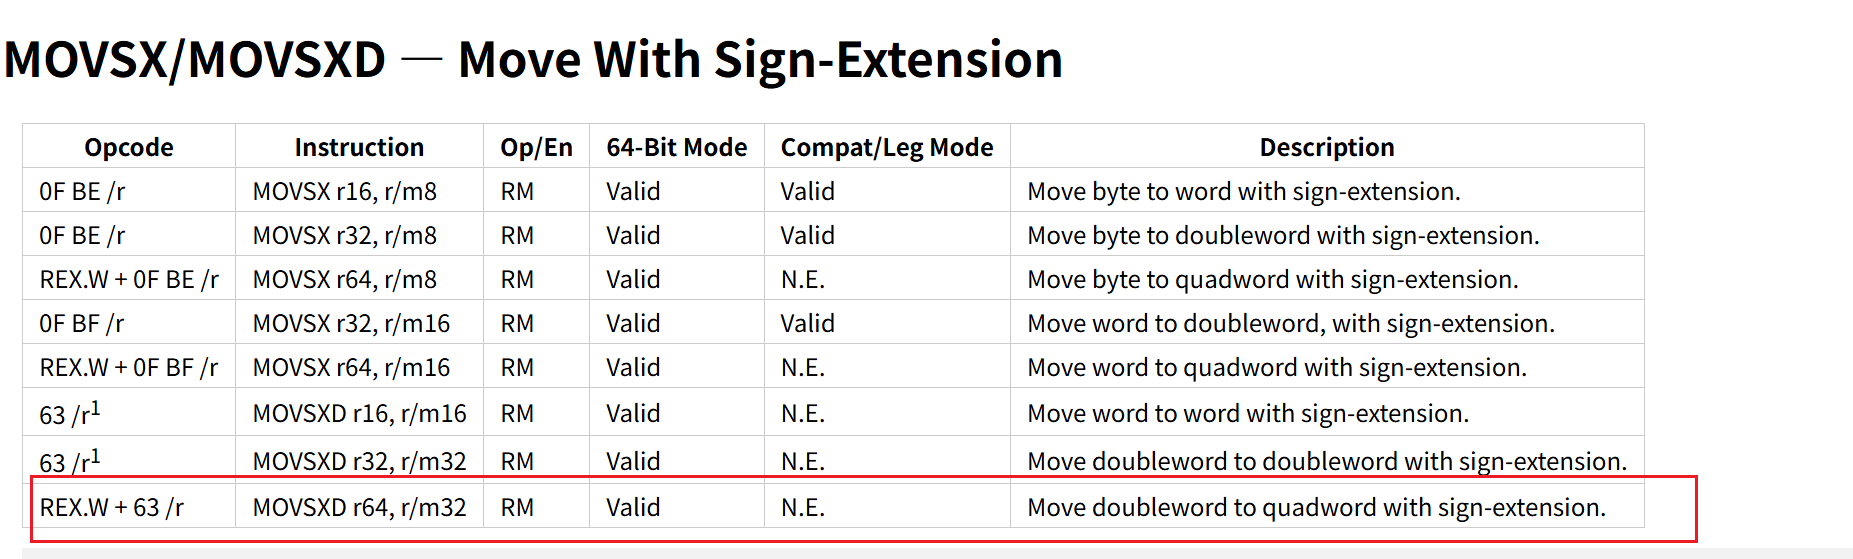
图 3: MOVSXD 编码表。r/m32 表示 32 位寄存器或内存操作数,r64 表示 64 位目标寄存器。
2.2 int → float:数值转换与舍入
int 和 float 都是 32 位,但表示方式不同。i2f 需要把整数值转换为浮点数值,不能简单地把原来的位模式当作 float 使用。
模板解释器中对应的分支为:
| |
汇编器方法如下:
| |
限定在 Legacy SSE 编码分支,并采用这里的 xmm0、rax 参数时,生成的指令为:
| |
它将 eax 中的 32 位有符号整数转换为单精度浮点数,并写入 xmm0 的低 32 位。若进入 AVX 分支,编码形式会不同,不能继续套用这组 Legacy SSE 机器码。

图 4: CVTSI2SS 指令表。表中的 xmm1 是操作数记号,不表示这里必须使用物理寄存器 xmm1。
int → float 虽然属于拓宽转换,但可能损失精度:
| |
单精度浮点数无法精确表示这里的原始整数,转换时发生了舍入。拓宽转换不等于“所有数值信息都能完整保留”。相关规则见 JLS §5.1.2。
2.3 窄化转换:可能改变数值
整数窄化转换可能丢弃高位,结果还可能改变符号:
| |
这里保留低 8 位,再按 byte 的有符号表示解释。基本数值类型转换本身不会因为这种溢出而抛出异常。
浮点数转整数有不同规则:小数部分向零截断,NaN 转为零;超出目标 int 或 long 范围时,先得到相应边界值。转为 byte、short、char 时,还会在转换到 int 之后进行一次窄化,不能直接理解为“限制到 byte/short/char 的边界”。详见 JLS §5.1.3。
boolean 不参与数值基本类型之间的转换,不能通过强转在 boolean 与 int 等数值类型之间互换。
三、装箱与拆箱:转换链需要分步看
3.1 基本类型转包装类型:装箱
示例中的:
| |
对应的关键字节码为:
| |
这里先得到 int 值,再调用 Integer.valueOf 得到包装对象引用,最后保存引用。装箱不意味着每次都创建新对象;valueOf 可以返回缓存对象。
3.2 包装类型转基本类型:拆箱后拓宽
再看:
| |
其关键指令为:
| |
aload 从当前栈帧的局部变量表加载 b 的引用,并非从常量池加载对象。随后调用 Integer.intValue() 取得 int 值,再通过 i2f 转换为 float。
| |
如果 b 为 null,拆箱会抛出 NullPointerException,数值转换尚未执行:
| |
3.3 Integer → Long:不能直接引用强转,可以转换数值
对于下面这段代码:
| |
完整转换链是:
| |
其中 (long) b 完成拆箱和基本类型拓宽,赋值给 Long 时再装箱。关键字节码为:
| |
以下几种写法的含义不同:
写法,假设 Integer b = 2 | 结果 |
|---|---|
Long e = (long) b; | 可以编译:拆箱、拓宽,再装箱 |
Long e = b.longValue(); | 可以编译:方法返回 long,再装箱 |
Long e = (Long) b; | 编译失败:Integer 不能直接强转为 Long |
Long e = b; | 编译失败:该赋值不允许自动组合拆箱、拓宽、再装箱 |
Long e = (Long) (Object) b; | 可以编译,但运行时报 ClassCastException,对象仍然是 Integer |
因此,准确的说法是:不能把 Integer 对象直接通过引用强转变成 Long 对象,但可以取得它的数值,完成数值转换,再得到 Long 包装对象。
四、引用类型转换:编译通过为什么仍然会失败
看下面这个完整示例:
| |
这里的 Main 是普通的非 final 类。编译器不能排除某个 Main 的子类实现 Map 的可能,因此允许从接口类型 Map 转换到 Main。但运行时实际对象是 HashMap,它不是 Main 的实例,检查便会失败。
如果将这里的 Main 改为未实现 Map 的 final 类,编译器可以排除这种可能,转换会直接编译失败。

图 5:异常堆栈
异常堆栈能够定位触发转换的 Java 源码行,但不会直接展开 HotSpot 内部生成类型检查代码和进入异常处理入口的实现过程。为理解这部分逻辑,需要继续看字节码。
| |
aload 加载引用,checkcast 检查它是否可以作为目标类型使用。检查通过后才会继续执行 astore;检查失败则抛出异常。
4.1 编译期检查与运行时检查的边界
编译器依据表达式的静态类型和语言规则,判断转换是否允许;运行时检查则针对实际对象。对于这个例子,map 的静态类型为 Map<String, String>,实际对象类型为 HashMap。
阅读 javac 的 Types.isCastable(Type t, Type s) 时,要注意它的参数方向:t 为源类型,s 为目标类型。不要把源码参数名直接套入习惯使用的 T result = (T) source 记号。
其中,t.isPrimitive() != s.isPrimitive() 表示恰好一方为基本类型。类似 boxedClass(s) 的调用用于取得编译器内部的包装类型信息,不表示编译器此时执行了用户程序中的装箱操作。
在本文使用的 JDK 8 源码中,相关分支如下,后续的类型访问器逻辑在此省略:
| |
这个分支先检查已有转换规则;当目标为基本类型时,还会在相应语言级别允许的前提下,判断目标包装类型与源类型之间的关系。例如,Object value = Integer.valueOf(1); int n = (int) value; 涉及从引用到包装类型的检查及拆箱。isCastable 返回允许,并不保证运行时引用一定兼容或一定非空。
允许转换之后,编译器还需要生成相应字节码。对于本文讨论的普通引用类型,可以用下面的简化逻辑理解:
| |
在 Gen.visitTypeCast 中,可以直接看到生成 checkcast 的条件:
| |
这里的 if 只控制额外的引用类型检查,不能反推成“不满足条件就不需要任何转换”。必要的基本类型转换等操作已经由前面的表达式生成逻辑处理。
前面的流程只是帮助区分阶段的说明,不是 javac 的完整算法。泛型、交叉类型、未经检查的转换,以及不同版本新增的语言特性,需要结合相应版本源码分析。
五、checkcast 的规范语义
checkcast 的格式为:
| |
后面的两个无符号字节组成运行时常量池索引:
| |
对应常量池项必须是类、数组或接口类型的符号引用。
执行时,先处理 null;对于非空引用,解析目标类型并检查对象是否兼容。成功时,操作数栈中的引用保持不变;不兼容时,抛出 ClassCastException。目标类型解析过程中,也可能出现规范规定的链接异常。
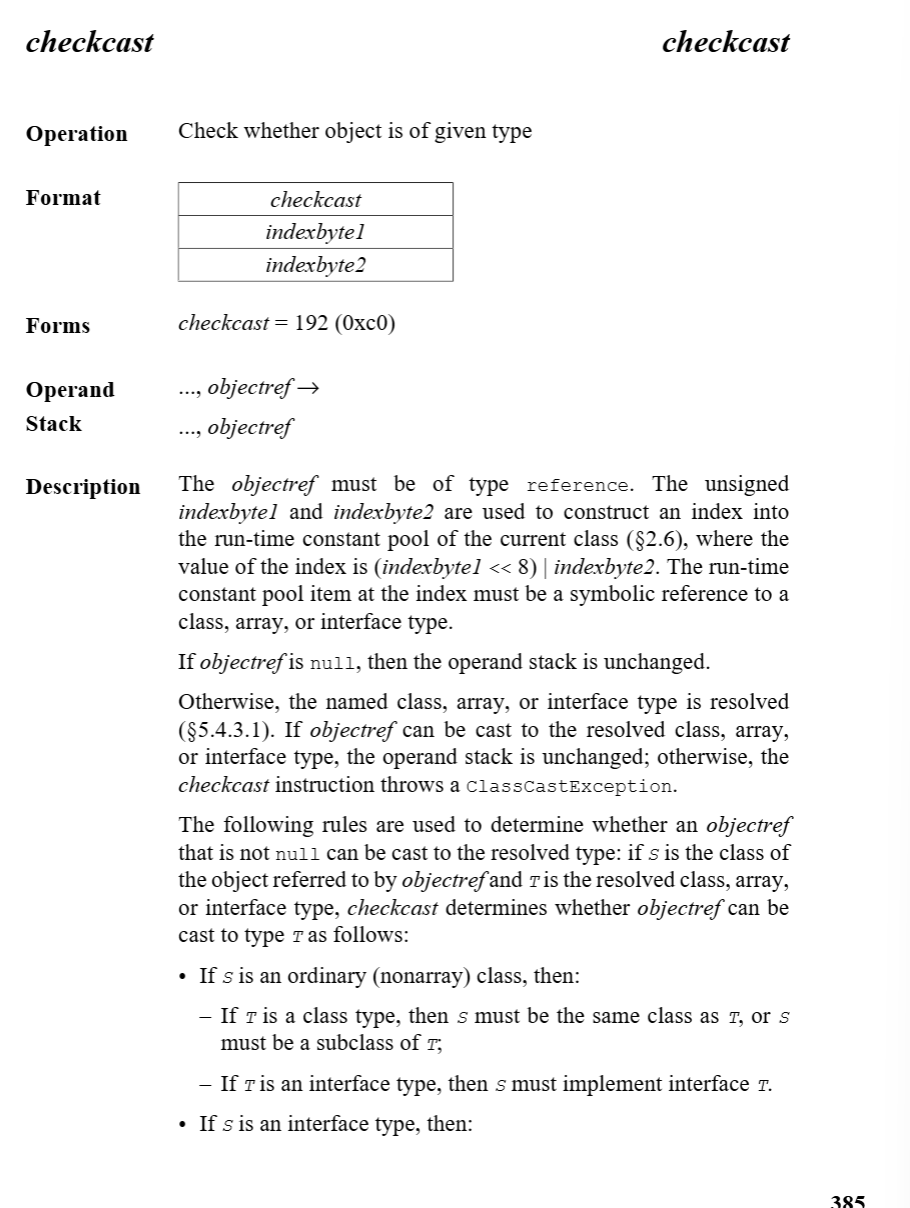
图 6: checkcast 格式与语义摘图。“解析目标类型”和“检查对象是否可转换”是两个不同步骤。
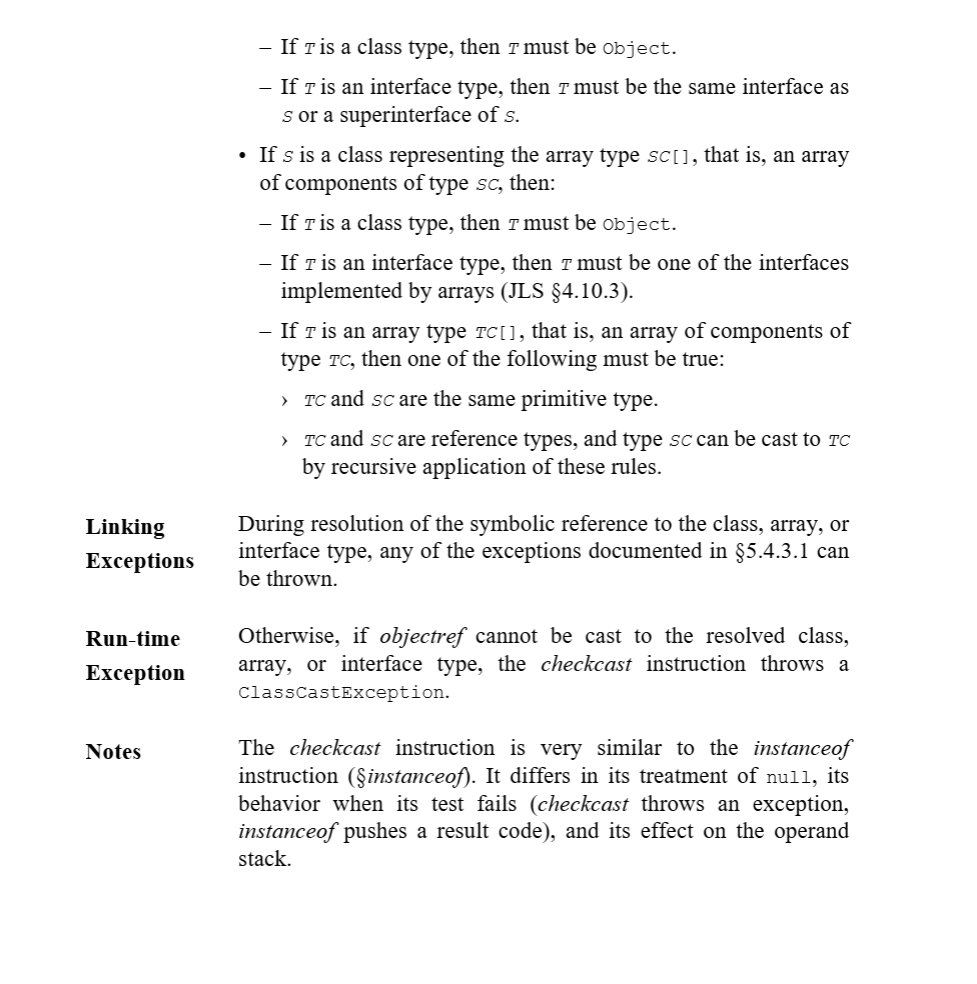
图 7:数组规则及异常说明。详见 JVMS §6.5 checkcast。
5.1 null 引用可以通过检查
在上一节 Main 的声明前提下,下面的代码可以编译并运行:
| |
不过,null 不会绕过编译期的类型规则;源类型与目标类型之间必须先允许这种转换。它也不意味着后续可以安全解引用,更不意味着可以安全拆箱。
5.2 兼容性针对实际对象判断
令 S 为对象的运行时类型,T 为目标类型。对于普通对象:
T为类时,S必须等于T,或者是T的子类。T为接口时,实际对象所属的类必须实现T,包括经继承得到的实现关系。
不能因为变量声明为接口,就把它的运行时类型也当成接口。例如,Map 变量可以持有 HashMap 对象,检查时关注的是实际对象的类型。
对于数组 SC[],规则为:
- 目标为类时,可以转换到
Object。 - 目标为接口时,可以转换到数组实现的
Cloneable或java.io.Serializable。 - 目标也为数组
TC[]时,若两边组件类型都是基本类型,必须相同;若都是引用类型,则递归检查SC与TC的兼容性。一边为基本类型、另一边为引用类型时不能通过。
例如,String[] 可以作为 Object[] 使用,int[] 则不能作为 Object[] 使用;但 int[] 本身是对象,可以作为 Object 使用。
六、HotSpot 如何生成 checkcast 的执行代码
TemplateTable::checkcast() 的主线可以概括为:
| |
HotSpot 中的 Klass 是描述类型的元数据结构,不等同于 Java 层面的 java.lang.Class 对象。
下面按执行阶段解释,避免把整段汇编生成代码与主线混在一起。此处的 __ testptr、__ jcc 等调用都在生成机器指令;真正检查用户对象的是随后运行这些指令的解释器代码。
6.1 检查空引用
入口处的关键代码为:
| |
transition(atos, atos) 声明模板执行前后的栈顶状态都是引用类型。按这里的 x86-64 解释器约定,该栈顶引用缓存在 rax 中;这条状态声明本身不等于执行一次寄存器搬运。
testptr(rax, rax) 在此生成测试指令。CPU 对 rax 与自身进行按位与运算,用结果更新标志位,但不把运算结果写回寄存器。当 rax 为零时,ZF = 1,后续条件跳转进入 is_null 分支。
6.2 取得常量池与目标类型索引
| |
执行完这些生成的指令后:
| 寄存器 | 此阶段保存的内容 |
|---|---|
rcx | 当前方法关联的运行时常量池指针 |
rdx | 常量池标签数组指针 |
rbx | checkcast 操作数给出的常量池索引 |
这一路径通过解释器帧取得当前 Method,再由 ConstMethod 找到关联的 ConstantPool。这里的 rbp 是解释器帧指针,不应称为栈顶指针;常量池也不是每个方法各自独立拥有的一份。
在所分析实现中,r13 保存当前字节码指针。索引读取从字节码起始位置偏移 1 字节开始,跳过操作码,读取后面的两个字节。
| |
字节码中的该索引按大端顺序存储,x86 使用小端顺序。这里先读取无符号 16 位值,再通过字节交换和右移得到正确索引,不能只把 bswapl 单独拿出来解释整个转换过程。
6.3 解析目标类型并取得两个 Klass
解释器检查目标常量池项的解析状态。已经解析时直接取得相应类型元数据;尚未解析时,通过 InterpreterRuntime::quicken_io_cc 等运行时入口完成解析。
解析只回答“目标类型是什么”,之后仍然需要判断“当前对象是否兼容”。解析完成并加载对象实际类型后,用于子类型检查的寄存器关系为:
| 寄存器 | 此阶段保存的内容 |
|---|---|
rax | 目标类型的 Klass* |
rbx | 实际对象所属类型的 Klass* |
rdx | 原对象引用 |
同一个寄存器在不同阶段会被复用,因此不能把前一张表中的用途一直延续到这里。
6.4 类型检查与异常入口
核心调用为:
| |
它继续生成子类型检查代码。检查成功会跳转到 ok_is_subtype,将保存在 rdx 中的原引用恢复到 rax,保持结果引用不变;检查失败则进入异常处理路径:
| |
空引用路径和正常成功路径最后都会完成必要的收尾工作。性能分析相关的计数逻辑不改变“成功时保留原引用”这一语义。
七、子类型检查为什么有快路径和慢路径
gen_subtype_check 继续调用 check_klass_subtype,后者利用 Klass 中的父类型信息,避免每次都逐层遍历继承关系。
7.1 同一类型直接通过
快路径首先比较两个类型元数据指针:
| |
如果实际类型与目标类型相同,就可以直接判定成功。这是类型元数据的身份比较,不是比较类名字符串。
7.2 _primary_supers:通过固定偏移检查父类型
对于适合放入 primary super 链的类型,Klass 中保存 _primary_supers。例如:
| |
可以将其有效条目理解为下表;这里省略固定长度数组中未使用的部分:
| 类型 | _primary_supers[0] | _primary_supers[1] | _primary_supers[2] |
|---|---|---|---|
Object | Object | — | — |
Animal | Object | Animal | — |
Dog | Object | Animal | Dog |
注意,这些条目包括类型自身,不只是严格意义上的父类。
类型还会记录 _super_check_offset。对于 primary super 情况,这个偏移对应自身深度的数组槽位。构造逻辑可概括为:
| |
检查 Dog 是否为 Animal 的子类型时,先读取目标类型 Animal 的检查偏移,再用这个偏移访问实际类型 Dog 的 Klass。读出的条目如果正好是 Animal 的 Klass*,检查就成功。
这种方法成立的关键是:各 Klass 中相同数组槽位具有相同的布局偏移,因此目标类型可以提供用于检查实际类型的偏移。
7.3 _secondary_super_cache 与 _secondary_supers
所分析的 OpenJDK 8u 实现中,_primary_supers 的容量为 8,PRODUCT 构建的 primary_super_limit() 返回这一上限;非 PRODUCT 构建还允许通过 FastSuperclassLimit 调整有效上限。以下按通常的容量 8 解释。接口、超出 primary super 深度范围的类型,以及某些数组相关情形,需要使用 secondary super 机制,不能全部塞入单一父类链。
相关字段的职责为:
| 字段 | 作用 |
|---|---|
_secondary_supers | 保存需要通过 secondary 机制检查的父类型信息 |
_secondary_super_cache | 缓存此前慢路径成功找到的一个目标类型 |
_super_check_offset | 指示快路径应检查 primary 数组中的某个槽位,还是 secondary cache 槽位 |
快路径可以用统一的“偏移读取并比较”处理两类情况,但比较失败之后的含义不同:
- 检查的是 primary super 槽位:不匹配即可判定失败。
- 检查的是 secondary cache:不匹配只表示缓存未命中,还需要进入慢路径。
在这里分析的实现中,慢路径扫描 _secondary_supers。找到目标类型后更新缓存并成功返回;扫描后仍未找到,才判定失败。
| |
附录 A:SSE 前缀与 ModR/M 编码
simd_prefix_and_encode 根据 UseAVX 选择 VEX 或 Legacy SSE 编码路径。
| |
cvtsi2ssl 接收的是通用寄存器 Register src,中间的重载按寄存器编号转交给这个公共编码函数。这里复用的是编码逻辑,不是把整数源值先搬进 XMM 寄存器。
Legacy SSE 分支中的辅助方法如下:
| |
对于本文的 cvtsi2ssl(xmm0, rax),在 Legacy SSE 路径中,可将编码拆分为:
| 字节 | 含义 |
|---|---|
F3 | 该指令需要的 mandatory prefix |
0F 2A | 操作码 |
C0 | ModR/M:寄存器寻址,目标 xmm0,源 eax |
附录 B:jcc
Label 表示代码生成阶段的跳转目标,主要分两种场景,Label在jcc之前还是之后绑定(bind)。如果当前Label已经绑定位置,那么计算offset,在此处cc为Assembler::zero,即0x4,因此指令为74 cb | JE rel8或0F 84 cd | JE rel32,语义都为判断ZF = 1时进行跳转。但是如果jcc方法在Label绑定之前调用,就需要有另外的处理了,因为此时还不知道需要跳转到哪个位置,因此指令为JE rel8,后面跟了一个0用于占位,后续Laebl绑定时,再补齐位移。
以下是 jcc 的核心逻辑,:
| |
对于 Assembler::zero,条件编码为 0x4。已绑定目标可以根据距离使用短跳转或近跳转;尚未绑定目标时,这里的 jcc 生成:
| |
后面的 4 字节零值是相对位移的占位内容。回填的是相对于跳转指令结束位置的位移,不是目标的绝对地址。需要显式生成短跳转时,应区分源码中的 jccb 路径。
规范与源码索引
- JLS 第 5 章:类型转换与转换上下文:拓宽、窄化、装箱、拆箱和强转规则。
- JVMS 第 6 章:虚拟机指令集:
aload、i2l、i2f、checkcast等指令的规范语义。 - templateTable_x86_64.cpp:转换指令与
checkcast的模板解释器实现。 - assembler_x86.cpp:转换指令编码、SIMD 前缀及
jcc。 - assembler_x86.hpp:寄存器编码辅助函数及重载。
- interp_masm_x86_64.cpp:字节码索引读取等解释器辅助实现。
- macroAssembler_x86.cpp:子类型检查的快路径和慢路径。
- klass.hpp、klass.cpp:
Klass字段及父类型信息初始化。 - Types.java:编译期强转合法性检查。
- Gen.java:强转表达式的字节码生成。
评论
评论审核后展示。邮箱不会公开,当前暂不发送回复邮件。