前两天面试,问我注解原理是什么,不知道这是想问什么,没有回答出来。
先自己声明一个注解:
| |
@interface 声明一个注解类型,注解上面的 @Target、@Retention、@Documented 为元注解,用于说明这个注解可以放在哪里、保留到什么时候,以及是否出现在生成的 API 文档中。
然后使用它:
| |
这里已经出现了两件不同的事:Anno 定义注解的类型和成员,@Anno(...) 则是在 Demo 上放了一份具体的注解信息。后面看字节码时,需要把这两件事分开。
1、@interface
对于注解编译后的字节码,通过 javap -v 可以看到,注解类型对应一个接口,父接口为 java.lang.annotation.Annotation。省略常量池和元注解后,关键结构如下:
| |
这里使用 javap -v,主要是方便把 access_flags 单独列出来,与 JVM 规范逐项对应。IDEA 插件、ASM 等工具可能采用另一种文本表示,例如:
| |
这种表示把部分标志转成了 abstract、@interface 等可读文字,这篇使用 javap -v,更接近jvm原始格式。
再看 JVM 规范中对 access_flags 的定义:
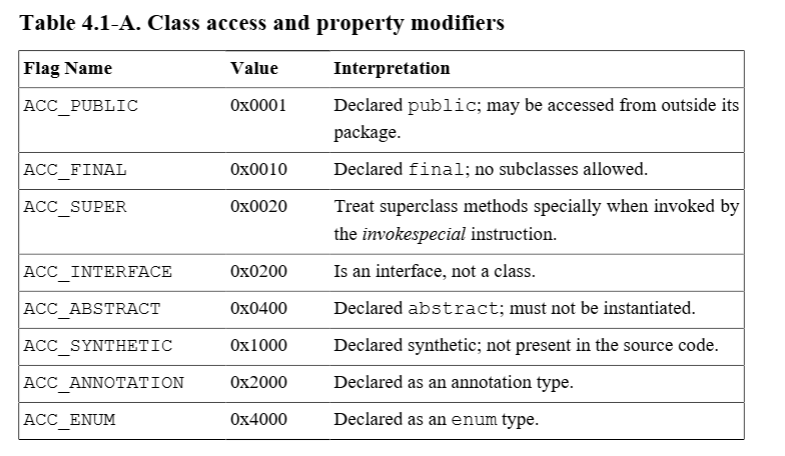
ACC_ANNOTATION 表示这是注解类型,并要求同时设置 ACC_INTERFACE;接口又必须设置 ACC_ABSTRACT。因此一个注解类型会包含这三个标志。示例中的 Anno 还是 public,所以再加上 ACC_PUBLIC,合起来为 0x2601。
这里也可以解释为什么注解成员写起来像方法。String value() 编译后就是一个无参数、返回 String 的抽象方法,count()、tags() 同理。使用 anno.value() 时,确实是在调用方法,并不是直接读取一个名为 value 的 Java 字段。
不过,注解类型也不能完全按普通接口来写。注解成员不能带参数,也不能声明方法体;返回类型限于基本类型、String、Class、枚举、注解类型,以及这些类型的一维数组。不能直接返回 List<String>、普通业务对象或多维数组,也不能把 null 作为注解成员值。
default 1 表示注解成员的默认值,不是 Java 8 接口中带方法体的 default 方法。它在 class 文件中保存在该成员方法的 AnnotationDefault 属性里,后面解析注解时会用到。
另外,@Anno("demo") 是 @Anno(value = "demo") 的简写。省略成员名的单元素写法要求这个成员叫 value,并且其余成员都有默认值。如果还要显式填写其他成员,就写成 @Anno(value = "demo", count = 2),不能混用省略名的值和具名成员。
2、元注解
元注解本身也是注解。它们能影响编译和反射,是因为编译器、文档工具和 JDK 中有代码识别并处理它们,并不是注解自己执行了某段逻辑。
最常用的是 @Target 和 @Retention,它们分别标记注解的使用位置和注解的生命周期。
@Target 的参数是 ElementType 数组。示例中的 TYPE、FIELD、METHOD 分别允许将 @Anno 放到类型声明、字段和方法上。除此之外,还有 PARAMETER、CONSTRUCTOR、LOCAL_VARIABLE、ANNOTATION_TYPE、PACKAGE 等位置。
Java 8 又增加了 TYPE_PARAMETER 和 TYPE_USE。前者用于类型参数声明,后者用于类型使用位置,例如 List<@SomeAnno String> 中的 String。这种类型注解和本文主要分析的类声明注解,在 class 文件中的存储属性、反射读取入口上都有区别,不能全部套用 Class.getAnnotation()。
@Retention 则决定注解信息保留到哪一步。下面先限定为本文这种标在类声明上的注解:
| 策略 | javac 编译后的结果 | 能否通过 Class.getAnnotation() 读取 |
|---|---|---|
SOURCE | 不把这处注解使用写入 class 文件 | 不能 |
CLASS | 写入 class 文件,但不要求供运行时反射使用 | 不能 |
RUNTIME | 写入 class 文件,并保留给运行时反射使用 | 可以,在对应查询规则下读取 |
如果没有写 @Retention,默认是 CLASS。
继续看 @Documented。它用于说明:使用这个注解时,标准文档工具生成 API 文档,应把这处注解信息包含进去。它不负责决定反射能不能读到注解,这个问题由保留策略等规则决定。
@Inherited 主要影响类注解沿父类链的查询:一个注解类型标记了 @Inherited,子类没有直接声明该注解时,Class.getAnnotation() 可以继续从父类查找。
| |
输出为:
| |
getDeclaredAnnotation() 只看当前类直接声明的注解,所以第二行是 null。第三行也是 null,因为 @Inherited 不会让实现类通过这套规则取得接口上的注解。它也不会让重写方法自动继承被重写方法上的注解。
最后一个是 Java 8 增加的 @Repeatable,允许同一种注解在同一位置重复出现。它通过一个容器注解包含多个注解值:
| |
在这个例子里,class 文件中不是并排放两条相同类型的 Tag 记录,而是把重复使用表示成容器注解,效果相当于:
| |
在本次 JDK 8 验证环境中,输出为:
| |
第二行是容器注解的 toString() 结果,其具体格式可能随 JDK 版本变化。示例把 Tag、Tags 声明为包内顶层类型,因此名称为 org.khr.base.Tag、org.khr.base.Tags;只有声明为 Main 内部类型时,才会出现 Main$Tag 这样的名称。
两个 @Tag 会以容器的形式表示,getAnnotation(Tag.class) 不负责展开容器,而 getAnnotationsByType(Tag.class) 会处理这种情况。容器也有类型、保留策略和适用位置等约束,不能随意定义一个数组成员就算完成。
3、注解的存放
前面分析的是注解类型 Anno.class,这里看被标记的 Demo.class。对于 @Anno(value = "demo", tags = {"java", "annotation"}),这次注解使用的信息被写到 class 文件的属性中,不是往方法指令里插入一条“执行注解”的字节码。
在 Demo.class 中,可以看到类似下面的结构:
| |
这里省略了具体常量池编号,保留属性名和成员结构。
对于本文这种声明注解,RUNTIME 对应 RuntimeVisibleAnnotations,CLASS 对应 RuntimeInvisibleAnnotations,SOURCE 不写入对应注解使用信息。虽然叫 Invisible,class 文件里仍然存在这份注解使用信息,只是不能通过这套运行时反射接口读取。
这一点在 javac 的 ClassWriter.writeJavaAnnotations() 中很直观。下面节选分类部分:
| |
后面分别把 visibles 和 invisibles 写入对应属性。类、字段和方法声明上的注解分别放在相应结构的属性表中;参数注解、类型注解有自己的属性格式。
下面是 JVM 规范 §4.7.16 中单条注解记录的格式,核心是注解类型,以及一组成员名和值:
| |
type_index 指向常量池中表示注解类型描述符的 CONSTANT_Utf8_info;element_name_index 指向成员名;value 的类型为 element_value,其中先用 tag 区分值的种类,再存对应索引或嵌套结构。基本类型和字符串引用相应常量池项,枚举值记录类型名和常量名的索引,注解及数组值则还要继续解析内部结构。
示例没有显式写 count,这条使用记录也不必重复保存 count = 1。它的默认值位于 Anno.class 中 count() 方法的 AnnotationDefault 属性里,后面解析时再补进来。
4、反射怎么读到注解
现在已经知道元数据存在哪里,再看 Java 代码是怎么读出来的:
| |
输出为:
| |
先跟进 Class.getAnnotation()。JDK 8 中这个方法的实现很短:
| |
最后是从一个 Map 中,按注解类型取出对应对象。关键就在于这个 Map 是什么时候填进去的。
| |
这里先读取当前 Class 中的 annotationData。这个字段就是注解缓存,声明为 volatile transient。如果此前没有触发过相关解析,调试时可以看到它为 null;但不能仅凭“这是我第一次调用”就断言缓存一定为空,其他代码也可能已经读取过这个类的注解。
classRedefinedCount 用于判断缓存是否仍然有效。它是与类重定义相关的版本计数,不能理解成普通的“类重新加载次数”。这份 HotSpot 源码中,重定义类时还会递归增加其子类的相应计数,使依赖父类信息的反射缓存也有机会失效。
如果有缓存,而且记录的版本仍然一致,就直接返回;没有缓存或者版本不一致,则调用 createAnnotationData() 创建新结果,再用 CAS 尝试安装。两个线程可能同时做解析,CAS 失败的线程回到循环重新检查,并不是每次查询都创建一套注解对象。
进入 createAnnotationData(),先执行下面这句:
| |
这里的 getRawAnnotations() 和 getConstantPool() 是两个 native 方法。前者取得类注解的原始字节,后者返回访问运行时常量池所需的包装对象。JDK 的 Class.c 将它们分别注册到 JVM_GetClassAnnotations 和 JVM_GetClassConstantPool。先跟进第一个入口:
| |
这里从 Java 的 Class 对象取得对应的 HotSpot 类型元数据。对于普通类和接口,使用 InstanceKlass 中保存的类注解数据;基本类型和数组在这个入口返回 NULL。
InstanceKlass::class_annotations() 还经过了一层访问,不能把 InstanceKlass::_annotations 和注解字节数组当成同一个类型:
| |
Annotations 是汇集类、字段等注解信息的元数据结构,AnnotationArray 则是字节数组。它们和 Java 里的 java.lang.annotation.Annotation 接口也不是一回事。现在的问题变成:这段字节是什么时候保存进 InstanceKlass 的?
回到类加载时的 class 文件解析阶段。在 classFileParser.cpp 中,parseClassFile() 依次组织 parse_classfile_attributes()、create_combined_annotations(),随后通过 apply_parsed_class_metadata() 把已经分配的元数据交给新建的 InstanceKlass。
首先是parse_classfile_attributes()循环读取类级属性表,遇到 RuntimeVisibleAnnotations 时,对应分支如下:
| |
这个片段是 if / else if 链中的一个分支。这里的attribute_length 是属性内容的字节长度,另外还有一个注解数量是内容开头的 num_annotations。二者的关系如下:
| |
按本文示例编译出的 Demo.class,这段属性内容实测为 22 字节,num_annotations 为 1,这条注解中显式填写的成员有 value、tags 两个。长度、注解条数和成员数量是三个不同的量。
get_u1_buffer() 取得当前 class 数据缓冲区中的位置,此时还没有把内容复制到新数组。guarantee_more() 检查剩余数据是否足够;parse_annotations() 扫描并识别 HotSpot 需要特殊处理的注解;skip_u1_fast() 则让外层读取游标越过这一段属性内容,继续处理后面的属性。
这里 C++ 的 parse_annotations() 不是后面 Java 反射中的 AnnotationParser。它会读取部分结构、识别特定注解,但不会在此把每个普通业务注解都构造成 Java 动态代理对象。
属性循环结束后,才通过 assemble_annotations() 整理原始数据:
| |
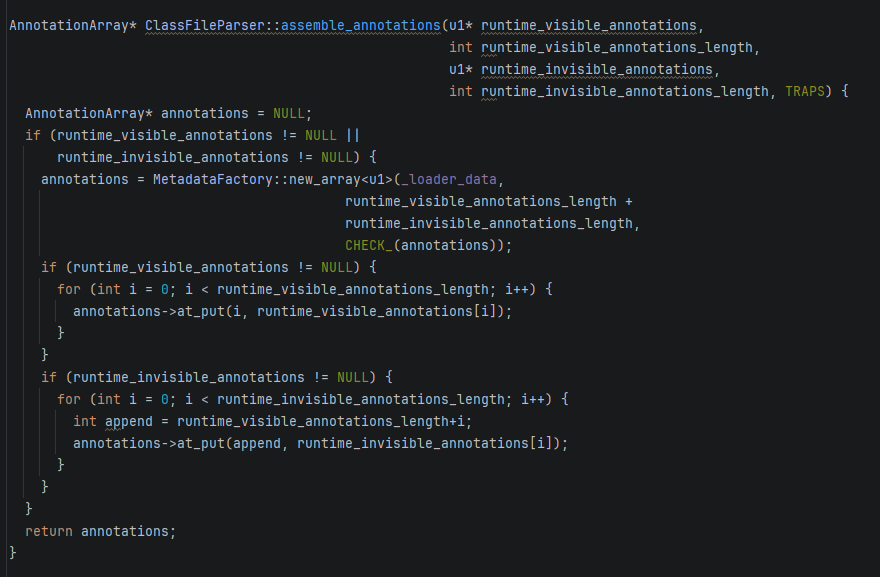
从截图中的 MetadataFactory::new_array<u1>() 和 at_put() 可以看出,这一步分配的是元空间中的字节数组,再把缓冲区里的内容逐字节复制进去。数组元素是字节,不是每个注解的地址,也不是解析后的成员对象。 所以它解决的是原始数据的保存问题,还没有得到前面示例中的 Anno 对象。
这个方法也接收 invisible annotations 的参数,但在本文对应的 HotSpot 中,保留这部分数据的分支受 PreserveAllAnnotations 控制,默认值为 false。不能因为看到了参数,就认为所有 CLASS 注解都会默认进入这段运行时元数据,更不能据此推导标准反射可以读到它们。
接着,create_combined_annotations() 分配 Annotations 元数据结构,把之前取得的几组数组放进去。以下节选了关键赋值,省略“完全没有注解时直接返回”等分支:
| |
这里的 combined 是汇集类、字段以及相应类型注解的存储结构,不是在合并父类注解。随后 apply_parsed_class_metadata() 执行:
| |
至此,InstanceKlass 才关联到了这组元数据。可以把保存过程连成:
| |
现在再回到 JVM_GetClassAnnotations()。它调用 Annotations::make_java_array(),把元空间中保存的字节复制到 Java 堆:
| |
Java 侧拿到的 byte[] 是一份副本,不是直接把元空间地址交给业务代码。这里复制的也不是整个 class 文件,而是保存下来的注解属性内容,包括其中的计数和常量池索引。
这就是 getRawAnnotations() 的来源。getConstantPool() 则为后续解析提供这些索引对应的类型描述符、成员名及常量值。这个过程读取已经保存的运行时信息,不需要重新从磁盘打开 Demo.class。
5、读出来的注解对象是什么
回到 Java 层,AnnotationParser.parseAnnotations() 先处理原始数组为 null 的情况,否则进入 parseAnnotations2()。前者是入口,后者遍历多条注解记录,parseAnnotation2() 则解析其中的一条。几个方法名字相近,作用需要分开。
为了方便阅读,下面把局部变量名展开,并按本地源码核对主线;这是调整过命名的版本,不是逐字摘录:
| |
ByteBuffer 默认按大端读取,与 class 文件的字节序一致。getShort() 返回有符号的 short,而规范中的 u2 是无符号数,所以通过 & 0xFFFF 得到 0~65535 范围内的值。第一次读取的是 num_annotations,不是上一节的属性字节长度。
解析完成的对象按注解类型放入 Map。这里还检查保留策略,只保留 RUNTIME 注解。Map.put() 返回旧值,如果同一个类型已经有值,就报重复注解错误。前面的合法 @Repeatable 不和这个规则矛盾,因为重复使用已被编译器表示成容器注解,外层这里读取的是容器记录。
进入 parseAnnotation2(),首先读取这条注解的类型:
| |
这里省略了异常处理和旧格式兼容分支。typeIndex 对应的是常量池中的 UTF-8 类型描述符,例如 Lorg/khr/base/Anno;,末尾的分号也是描述符的一部分。
parseSig() 解析的是这个已经取得的字符串,不是在读取文件。它通过 SignatureParser 构造类型描述,再由 Reifier 和 CoreReflectionFactory 取得对应 Class。对于这里的普通注解类型,最后会走到:
| |
到这里传入的 name 已经是 org.khr.base.Anno 这样的二进制名称,不能把带 L、斜杠和分号的描述符原样交给 Class.forName()。false 表示这次调用不要求初始化该类型;使用的加载器来自被解析注解所处的声明环境。类型查找仍可能触发加载器工作,不能把“不重新读取 Demo 的注解属性”和“绝不触发其他类型加载”混为一谈。
拿到注解的 Class 后,再取得它的 AnnotationType:
| |
AnnotationType.getInstance() 会尝试复用注解类型 Class 上的 annotationType 缓存,没有时才创建。它不是把 Class 对象变成另外一种对象,而是建立描述这个注解类型的辅助信息:
| |
memberTypes 保存成员名和返回类型,基本类型在这份内部映射中会使用对应包装类型,便于处理成员值;这不改变 Anno.count() 在字节码里返回 int 的定义。members 保存成员方法,memberDefaults 保存通过 Method.getDefaultValue() 读取到的默认值,retention 和 inherited 则来自相关元注解。
因此这里存在两种不同的缓存:Demo.class 的 annotationData 缓存“Demo 上有哪些注解及其具体值”;Anno.class 的 annotationType 缓存“Anno 有哪些成员、默认值和元注解规则”。
接下来读取 num_element_value_pairs,遍历使用位置显式填写的成员。以下为主线节选,省略不存在成员的跳过逻辑和类型不匹配处理:
| |
前面复制了默认值,这里再覆盖显式值。对于 Demo,最后可以把结果理解成:
| |
其中 count = 1 来自注解类型的默认值;value 和 tags 来自 Demo 上这次注解使用。这里不是所有值都直接从常量池取一个对象,数组、嵌套注解等还要继续解析相应结构。
现在类型和成员值都有了,最后由 annotationForMap() 创建可供 Java 代码使用的对象。下面省略外围的权限处理:
| |
代理对象由 Proxy.newProxyInstance() 创建,它实现 Anno 接口;AnnotationInvocationHandler 保存注解类型和成员值,并负责接收方法调用。接口本身不能直接实例化,但“它是接口”并不意味着任何实现都必须使用动态代理,这是这里的 JDK 反射实现选择。
继续看 AnnotationInvocationHandler.invoke()。下面保留主要分支,使用源码中的变量含义并整理缩进:
| |
调用 anno.value() 时,处理器拿到方法名 value,从 memberValues 中取得 "demo" 返回。anno.count() 则取得前面补入的默认值 1。
非空数组在返回前会复制一份。因此把拿到的 tags[0] 改成 "changed",再次调用 anno.tags(),读到的仍然是 "java"。不能通过修改返回数组,顺带改变处理器内部保存的成员值。
equals()、hashCode()、toString() 和 annotationType() 单独处理。anno.annotationType() 返回 Anno.class,而 anno.getClass() 返回代理类,两者不是同一个 Class。代理类的包名和编号可能变化,不应依赖固定的 $Proxy0 名称。
至此,一条原始注解记录才变成了一个可以调用方法的 Java 对象。再回到外层 Class.createAnnotationData(),处理当前类的全部直接注解后,还会检查父类:
| |
这段为主线节选,把源码中的 Map 容量计算省略了。父类也会通过自身的缓存或解析逻辑提供注解,只有对应注解类型带 @Inherited 才加入当前查询结果;随后 putAll() 用当前类直接声明的同类型注解覆盖父类结果。
最后保存的两份逻辑结果为:
| |
没有需要继承的注解时,源码直接复用同一个 Map,不是一定复制两份。这一步发生在 Java 反射构建查询缓存时,与前面 C++ 的 create_combined_annotations() 汇集元数据的工作不同。
把整个过程连起来,就是两段相接的调用链:
| |
这个过程说明了这份 JDK 中运行时反射的实现;编译器处理 @Override、注解处理器在编译期生成代码,并不需要先走这条动态代理调用链。
6、为什么加上注解就能执行某些功能
到这里,能解释的还是“信息怎么存进去,再怎么取出来”。至于依赖注入、权限校验、事务或者其他功能,需要有读取这份信息并执行动作的代码。
用前面的 Anno 写一个最简单的例子:约定 count 表示一个方法执行几次。
| |
运行后输出两次 hello。注解只提供 count = 2 这份配置,真正调用方法的是 main() 中的循环和 method.invoke()。这里的方法是无参数静态方法,所以调用时传入 null 作为接收对象;普通实例方法则需要相应实例。
如果直接调用一次 RunnerDemo.hello(),它就只输出一次,并不会因为标了 count = 2 自动再执行一次。
常用框架也是先定义注解语义,再在扫描、对象创建、调用拦截等阶段读取它,执行对应逻辑。有的步骤使用反射,有的直接读取 class 文件;并不是所有框架扫描都必须先调用 getAnnotation(),也不是每次业务调用都要重新解析一遍注解。
编译期也可以处理注解。JDK 提供 javax.annotation.processing.Processor 等接口,处理器在编译过程中通过元素、注解镜像等模型读取信息,进行检查或者生成源码、资源。SOURCE 注解虽然不保留到 class 文件,处理器在当前源码编译阶段仍然可以看到它。标准注解处理 API 也不能简单理解成可以任意修改已有方法体的入口。
因此,讨论一个具体注解“为什么生效”,还需要继续找到它的读取者。只定义注解、标在代码上,却没有任何编译器、工具或框架消费它,业务行为不会凭空发生变化。
7、回到“注解原理”这个问题
@interface 声明注解类型,编译后是带 ACC_ANNOTATION 标志并继承 Annotation 的接口;注解使用处按保留策略写入相应 class 文件属性;运行时反射解析这些元数据,合并默认值和显式值,在这份 JDK 中创建由 AnnotationInvocationHandler 处理调用的动态代理对象,并缓存解析结果。最后,编译器、工具或者框架读取这些信息,决定执行什么动作。
总的来说还是不知道怎么回答
附录:几个查询方法的区别
下面限定为对 Class 调用这些方法。表中的“沿父类查找”还要求注解类型具有 @Inherited 等条件,不包含接口搜索,也不能直接推广到方法、字段等所有 AnnotatedElement。
| 方法 | 是否展开重复注解容器 | 是否沿父类查找 | 未找到时 |
|---|---|---|---|
getAnnotation(A.class) | 否 | 按 @Inherited 规则查找 | null |
getDeclaredAnnotation(A.class) | 否 | 否 | null |
getAnnotationsByType(A.class) | 是 | 当前类展开后没有该类型结果时,按 @Inherited 规则继续查找 | 空数组 |
getDeclaredAnnotationsByType(A.class) | 是 | 否 | 空数组 |
getAnnotationsByType() 并不是把当前类和所有父类的同类注解不断拼接。如果当前类已经有该类型的直接声明或容器展开结果,就使用当前类的结果;只有当前类没有结果且符合继承条件时,才沿父类链继续找。
相关规范和源码:
JLS §9.6、§9.7:注解类型、成员、默认值、元注解与注解使用规则。
JVMS §4.1:class 文件访问标志。
JVMS §4.7.16—§4.7.22:声明注解、参数注解、类型注解和默认值的属性格式;
AnnotationDefault位于 §4.7.22。AnnotatedElement:反射查询、继承与可重复注解的规则。
ClassWriter.java:按保留策略写入注解属性。
Class.java:类注解查询、缓存及父类注解合并。
AnnotationParser.java:解析注解信息、合并成员值和创建代理。
AnnotationType.java:读取成员类型、默认值和相关元注解。
AnnotationInvocationHandler.java:处理成员访问及
equals、hashCode等方法。Class.c:注册 getRawAnnotations 与 getConstantPool 的 native 入口。
jvm.cpp:JVM_GetClassAnnotations 取得并复制类注解字节。
classFileParser.cpp:读取类属性、复制注解字节、组装并交付元数据。
annotations.hpp:AnnotationArray 与 Annotations 的实际类型和字段。
annotations.cpp:make_java_array 将元数据字节复制到 Java 堆。
instanceKlass.hpp:class_annotations 访问元数据中的类注解数组。
CoreReflectionFactory.java:解析类型名称时调用 Class.forName。
AnnotationSupport.java:ByType 查询处理容器和父类的规则。
jvmtiRedefineClasses.cpp:重定义时更新类及子类的版本计数。
评论
评论审核后展示。邮箱不会公开,当前暂不发送回复邮件。